سونو (Suno)، ابزار ساخت موسیقی با هوش مصنوعی، قابلیت تولید گفتار و صدای روایی از روی متن یا توضیحات کاربر را در نسخه بتای عمومی عرضه کرد؛ این ویژگی امکان ساخت همزمان نریشن و موسیقی پسزمینه را فراهم میکند.
سونو تولید گفتار با هوش مصنوعی را آغاز کرد
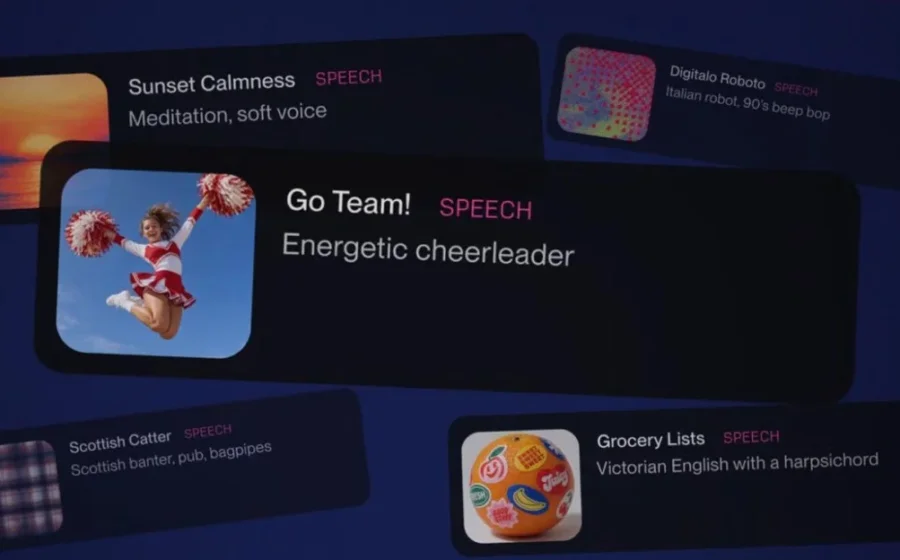
شرکت Suno که بیشتر به خاطر ساخت موسیقی با هوش مصنوعی شناخته می شود، قابلیت تازه ای برای تولید صدای گفتاری ارائه کرده است. این ابزار می تواند بر اساس متن آماده یا توضیحی که کاربر وارد می کند، گفتار تولید کند. قابلیت Speech اکنون در قالب نسخه بتای عمومی روی نسخه وب و اپلیکیشن موبایل سونو در دسترس است و امکان ساخت هم زمان روایت صوتی و موسیقی پس زمینه را فراهم می کند.
جک برودی، مدیر ارشد محصول سونو، درباره این قابلیت گفت: «موسیقی همچنان محور اصلی سونو و محصولاتی است که می سازیم؛ بااین حال، چشم انداز ما از ابتدا شکل های گوناگون بیان انسانی را نیز دربر می گرفت. امروز با عرضه Speech، دامنه امکانات سونو را گسترش می دهیم؛ این نخستین مدل صوتی است که صدا و موسیقی را به صورت یک قطعه منسجم در کنار هم تولید می کند.»
ورود سونو به بازار تولید گفتار
تولید گفتار با هوش مصنوعی فناوری تازه ای نیست. شرکت هایی مانند DeepMind سال ها روی سنتز گفتار با یادگیری عمیق کار کرده اند و Adobe نیز ابزار تبدیل متن به گفتار دارد. ElevenLabs هم از زمان آغاز فعالیت خود در سال ۲۰۲۳ به یکی از نام های مطرح این حوزه تبدیل شده است. سونو اکنون با ترکیب قابلیت تولید موسیقی و صدای مصنوعی وارد این رقابت شده است؛ اقدامی که می تواند به متنوع تر شدن فعالیت های این پلتفرم کمک کند، به ویژه آنکه بخش موسیقی آن با پرونده های حقوقی متعددی روبه رو بوده است.
تمایز رویکرد سونو، پیوند دادن موسیقی تولیدشده با صدای گفتاری است. افزودن موسیقی اختیاری است و کاربر می تواند با استفاده از یک گزینه، موسیقی پس زمینه را غیرفعال کند و تنها گفتار خالص را دریافت کند. بااین حال، سونو این قابلیت را برای کاربردهایی مانند همراه کردن شعر با موسیقی آرام، ساخت روایت های پرتحرک یا تولید سخنرانی های انگیزشی و نمایشی طراحی کرده است.
نحوه استفاده از قابلیت Speech
برای استفاده از این ابزار، کاربر باید وارد بخش Create شود و گزینه Speech را انتخاب کند. این قابلیت در دو حالت ارائه می شود. در حالت Simple، کاربر با نوشتن توضیحی در کادر درخواست، نتیجه موردنظر خود را مشخص می کند؛ برای نمونه می توان درخواست کرد صدای یک فرمانده کشتی داستانی، خدمه خود را برای حرکت آماده کند.
حالت Advanced برای زمانی است که کاربر متن دقیق گفتار را از قبل آماده کرده باشد. در تنظیمات پیشرفته، امکان انتخاب جنسیت صدای تولیدشده، سبک بیان و میزان تنوع میان خروجی های مختلف وجود دارد. مدت زمان هر فایل گفتاری نیز حداکثر حدود هشت دقیقه خواهد بود.
سونو: نسخه بتا هنوز کامل نیست
سونو تأکید کرده است که قابلیت جدید هنوز با محدودیت هایی همراه است و توسعه آن بر اساس بازخورد کاربران ادامه خواهد داشت. برودی درباره وضعیت فعلی Speech گفت: «بتا واقعاً به معنای نسخه بتاست. گاهی لهجه بریتانیایی ممکن است به لهجه استرالیایی نزدیک شود و دوباره بازگردد. مکث های نمایشی نیز شاید بیش از اندازه نمایشی باشند. تقریباً مطمئنیم کاربران کاربردهایی برای این ابزار پیدا خواهند کرد که تاکنون به ذهن ما نرسیده است.»
دیدگاهها