چهار شرکت بزرگ فعال در صنعت هوش مصنوعی، یعنی گوگل، OpenAI، مایکروسافت و آنتروپیک، از ایجاد یک روش مشترک برای اعلام مخالفت وبسایتها با استفاده از محتوایشان در آموزش مدلهای هوش مصنوعی حمایت کردهاند. این طرح میتواند یکی از مهمترین تغییرات در نحوه تعامل شرکتهای هوش مصنوعی با ناشران و تولیدکنندگان محتوای اینترنتی باشد.
براساس گزارش The Verge و اطلاعیههای رسمی منتشرشده در ۳۰ اکتبر ۲۰۲۶، استاندارد پیشنهادی به مدیران وبسایتها اجازه میدهد تنها با افزودن یک دستور مشترک به فایل robots.txt، ترجیحات خود را درباره استفاده از محتوا برای آموزش هوش مصنوعی به چندین شرکت اعلام کنند. البته این استاندارد هنوز در مرحله پیشنهادی قرار دارد و اجرای آن توسط تمام شرکتهای حامی آغاز نشده است.
توافق چهار غول هوش مصنوعی برای احترام به محتوای وبسایتها
شرکتهای توسعهدهنده هوش مصنوعی برای آموزش مدلهای زبانی و مولد خود به حجم گستردهای از دادهها نیاز دارند.
بخشی از این دادهها از محتوای عمومی اینترنت، از جمله وبسایتهای خبری، وبلاگها و منابع آموزشی جمعآوری میشود.
این فرایند در سالهای اخیر با اعتراض ناشران و صاحبان محتوا همراه بوده است؛ زیرا بسیاری از آنها معتقدند آثارشان بدون اجازه یا پرداخت هزینه در توسعه محصولات تجاری هوش مصنوعی استفاده میشود.
اکنون چهار شرکت OpenAI، گوگل، مایکروسافت و آنتروپیک اعلام کردهاند که از یک سازوکار مشترک برای اعلام ترجیحات ناشران حمایت خواهند کرد.
این اقدام میتواند مدیریت دسترسی شرکتهای هوش مصنوعی به محتوای وبسایتها را سادهتر کند.
بااینحال، توافق اخیر به معنای ممنوعیت کامل جمعآوری دادهها یا پایان اختلافات حقوقی درباره استفاده از محتوای اینترنت نیست.
استاندارد جدید جلوگیری از آموزش هوش مصنوعی چگونه کار میکند؟
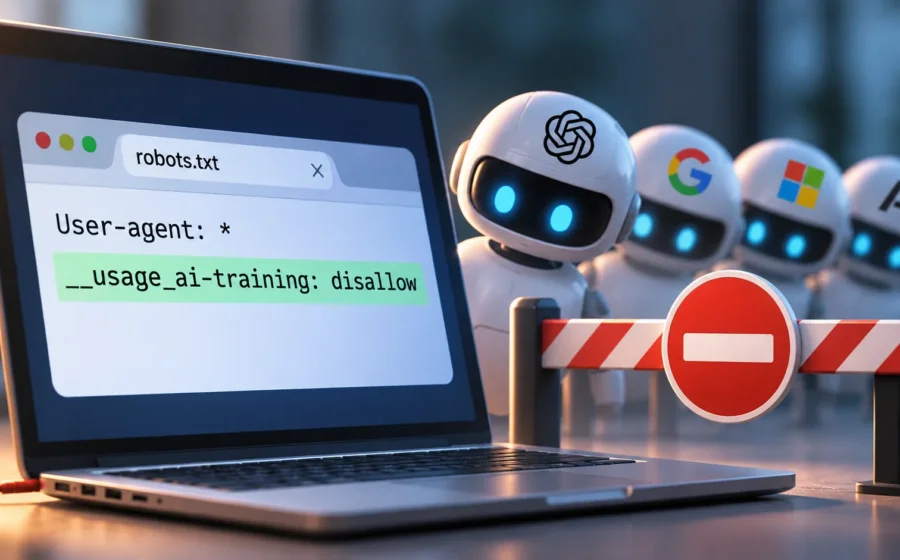
پیشنهاد جدید بر پایه فایل robots.txt طراحی شده است.
این فایل در وبسایتها برای اعلام دستورالعملهای مربوط به خزندههای اینترنتی استفاده میشود.
برای مثال، مدیر سایت میتواند از طریق آن مشخص کند کدام بخشهای وبسایت برای خزندههای مشخص مجاز یا غیرمجاز هستند.
در روش فعلی، مدیران وبسایتها معمولاً باید برای هر شرکت هوش مصنوعی قوانین جداگانهای تعریف کنند.
اما پیشنهاد جدید با معرفی یک نشانه مشترک به نام Policy Token تلاش میکند این فرایند را سادهتر کند.
نشانه پیشنهادی با عنوان __usage_ai-training شناخته میشود.
با استفاده از این نشانه، صاحب وبسایت میتواند مخالفت خود را با استفاده از بخشهایی از محتوایش برای آموزش مدلهای مولد اعلام کند.
شرکتهایی که از این استاندارد پشتیبانی میکنند، باید ترجیحات اعلامشده را مطابق تعهدات و سیاستهای اجرایی خود تفسیر کنند.
نقش آنتروپیک در طراحی استاندارد جدید
پیشنهاد فنی این سازوکار توسط کوین کلی، مسئول فنی استانداردها در شرکت آنتروپیک، ارائه شده است.
این پیشنهاد در چارچوب فعالیتهای مرتبط با گروه AI Preferences در سازمان مهندسی اینترنت یا IETF مطرح شده است.
IETF یکی از مهمترین نهادهای فعال در توسعه استانداردهای فنی اینترنت محسوب میشود.
طرح جدید با عنوان Machine-Readable Training Preference Signal در ۳۰ اکتبر ۲۰۲۶ ثبت شده است.
هدف آن فراهمکردن روشی است که ترجیحات مربوط به استفاده از محتوا برای آموزش هوش مصنوعی را بهشکلی قابلخواندن برای ماشین بیان کند.
نکته مهم این است که سند فعلی یک پیشنویس اینترنتی مستقل محسوب میشود و هنوز استاندارد رسمی و نهایی IETF نیست.
بنابراین، جزئیات فنی آن ممکن است در جریان بررسیها تغییر کند.
آیا سایتها میتوانند فقط بخشی از محتوای خود را محدود کنند؟
یکی از قابلیتهای مهم پیشنهاد جدید، امکان تعریف ترجیحات برای مسیرهای مختلف وبسایت است.
به این ترتیب، مدیر سایت مجبور نیست یک تصمیم یکسان برای تمام محتوای خود بگیرد.
برای مثال، یک ناشر میتواند استفاده از مقالههای اختصاصی خود برای آموزش هوش مصنوعی را غیرمجاز اعلام کند، اما استفاده از بخش دیگری مانند محتوای تبلیغاتی یا اطلاعیههای عمومی را مجاز بداند.
این انعطافپذیری برای رسانهها و وبسایتهایی که انواع مختلفی از محتوا منتشر میکنند، اهمیت دارد.
همچنین پیشنهاد جدید بدون ایجاد دستورهای کاملاً تازه در ساختار robots.txt طراحی شده است.
در نتیجه، هدف این است که ابزارهای فعلی مدیریت وبسایتها با کمترین تغییر بتوانند از سازوکار جدید پشتیبانی کنند.
زمان اجرای استاندارد توسط OpenAI، گوگل و مایکروسافت
با وجود اعلام حمایت چهار شرکت بزرگ، زمان اجرای این قابلیت در تمام پلتفرمها یکسان نیست.
طبق گزارشهای منتشرشده، آنتروپیک پشتیبانی از نشانه مشترک را آغاز کرده است.
OpenAI نیز در اطلاعیه رسمی خود اعلام کرده قصد دارد این قابلیت را طی ماههای آینده پیادهسازی کند.
گوگل و مایکروسافت برنامه دارند پشتیبانی از استاندارد مشترک را در سال ۲۰۲۷ ارائه دهند.
بنابراین، هنوز نمیتوان گفت تمام خزندههای این شرکتها از همین امروز بهصورت کامل از نشانه جدید پیروی میکنند.
اجرای عملی این استاندارد به توسعه ابزارها و اعلام جزئیات فنی توسط شرکتهای مربوط بستگی دارد.
آیا جلوگیری از آموزش هوش مصنوعی به سئوی سایت آسیب میزند؟
یکی از نگرانیهای اصلی مدیران وبسایتها این است که جلوگیری از استفاده محتوای آنها برای آموزش هوش مصنوعی، باعث حذف صفحاتشان از نتایج جستوجو شود.
گوگل و مایکروسافت تلاش کردهاند میان این دو کاربرد تفاوت قائل شوند.
مایکروسافت اعلام کرده تنظیمات مربوط به آموزش هوش مصنوعی و استفاده از محتوا برای پاسخگویی مبتنی بر منابع را از یکدیگر جدا خواهد کرد.
همچنین این شرکت میگوید ترجیحات مربوط به آموزش هوش مصنوعی نباید بهتنهایی باعث حذف صفحات از نتایج جستوجوی Bing شوند.
گوگل نیز پیشتر از ابزار Google-Extended برای مدیریت برخی کاربردهای محتوای وب در خدمات هوش مصنوعی استفاده کرده است.
طبق اطلاعیه جدید گوگل، این شرکت قصد دارد در شرایط مشخص، نشانه مشترک را مشابه محدودیت Google-Extended تفسیر کند.
بااینحال، نحوه نمایش محتوا در قابلیتهای مختلف هوش مصنوعی با رتبهبندی سنتی موتور جستوجو یکسان نیست و ممکن است به تنظیمات متفاوتی وابسته باشد.
آیا استاندارد جدید جلوی تمام خزندههای هوش مصنوعی را میگیرد؟
خیر. یکی از مهمترین نکات درباره این طرح، تفاوت میان جمعآوری محتوا و استفاده از آن برای آموزش هوش مصنوعی است.
در متن فنی پیشنهاد جدید تأکید شده که نشانه مشترک اساساً برای اعلام ترجیحات مربوط به استفاده از محتوا طراحی شده است، نه مسدودکردن فنی تمام درخواستهای خزندهها.
بنابراین، این دستور بهتنهایی مانند یک دیوار امنیتی عمل نمیکند.
همچنین شرکتهایی که از استاندارد پشتیبانی نمیکنند، لزوماً ملزم به رعایت آن نخواهند بود.
این سازوکار نیز بهصورت خودکار دادههایی را که قبلاً برای آموزش مدلها جمعآوری شدهاند، از مجموعه دادههای آموزشی حذف نمیکند.
در نتیجه، استاندارد پیشنهادی بیشتر ابزاری برای اعلام یکپارچه ترجیحات ناشران است و نباید آن را تضمینی برای توقف کامل جمعآوری اطلاعات اینترنتی دانست.
موضع متا درباره استاندارد جدید چیست؟
شرکت متا، مالک فیسبوک و اینستاگرام، نیز از ایده ایجاد یک استاندارد مشترک استقبال کرده است.
اندی استون، مدیر ارتباطات متا، اعلام کرده وجود یک نشانه مشترک برای انتقال ترجیحات ناشران به چندین ارائهدهنده هوش مصنوعی میتواند گام مهمی باشد.
بااینحال، متا هنوز بهصورت مشخص تأیید نکرده که چه زمانی این نشانه را در خزندههای خود اجرا خواهد کرد.
بنابراین، وضعیت متا با چهار شرکتی که تعهد مشخصتری برای پشتیبانی اعلام کردهاند، متفاوت است.
این تفاوت نشان میدهد موفقیت استاندارد جدید به میزان مشارکت شرکتهای بیشتری از صنعت هوش مصنوعی وابسته خواهد بود.
نقش Cloudflare در مقابله با جمعآوری اطلاعات توسط هوش مصنوعی
اقدام اخیر تنها تلاش برای افزایش کنترل ناشران بر محتوای اینترنت نیست.
شرکت Cloudflare نیز پیشتر ابزارهایی برای مدیریت فعالیت خزندههای هوش مصنوعی معرفی کرده است.
این شرکت در سپتامبر ۲۰۲۶ قابلیت Disallow AI Training را ارائه کرد که به مدیران وبسایتها اجازه میدهد با استفاده از تنظیمات مشخص، مخالفت خود را با استفاده از محتوا برای آموزش مدلها اعلام کنند.
Cloudflare همچنین ابزارهایی برای مسدودسازی فنی برخی خزندهها فراهم کرده است.
تفاوت مهم این روشها با پیشنهاد جدید آن است که استاندارد مشترک تلاش میکند ترجیحات ناشران را برای چندین شرکت هوش مصنوعی بهصورت یکپارچه بیان کند.
در مقابل، ابزارهای زیرساختی میتوانند برای مدیریت یا مسدودکردن واقعی ترافیک خزندهها به کار گرفته شوند.
این دو رویکرد الزاماً جایگزین یکدیگر نیستند و ممکن است در کنار هم استفاده شوند.
آیا این توافق به اختلاف ناشران و شرکتهای هوش مصنوعی پایان میدهد؟
اختلاف بر سر استفاده از محتوای اینترنت برای آموزش هوش مصنوعی، ابعاد فنی، اقتصادی و حقوقی مختلفی دارد.
ناشران میخواهند درباره نحوه استفاده از آثارشان اختیار بیشتری داشته باشند و در برخی موارد برای استفاده تجاری از محتوا حق دریافت هزینه قائل هستند.
در مقابل، شرکتهای هوش مصنوعی برای توسعه مدلهای قدرتمند به منابع گسترده اطلاعاتی نیاز دارند.
استاندارد جدید میتواند یکی از مشکلات فنی این اختلاف را کاهش دهد؛ یعنی دشواری اعلام ترجیحات به شرکتهای مختلف.
اما موضوعاتی مانند استفاده از دادههای قبلی، حقوق مالکیت فکری، قراردادهای مجوز محتوا و نظارت بر رعایت درخواست ناشران همچنان باقی میمانند.
در مجموع، حمایت گوگل، OpenAI، مایکروسافت و آنتروپیک از یک نشانه مشترک را میتوان گامی مهم بهسوی شفافترشدن رابطه میان صاحبان وبسایتها و توسعهدهندگان هوش مصنوعی دانست.
بااینحال، میزان تأثیرگذاری واقعی این طرح زمانی مشخص خواهد شد که استاندارد نهایی شود، شرکتها آن را اجرا کنند و سازوکارهای نظارت بر رعایت ترجیحات ناشران روشنتر شوند.

دیدگاهها