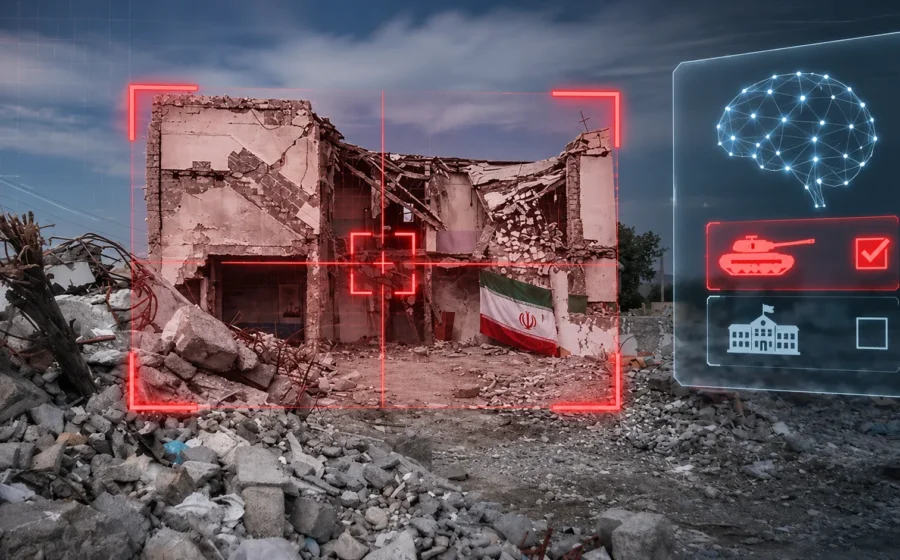
پژوهش جدیدی درباره ایمنی مدلهای پیشرفته هوش مصنوعی، نتایج نگرانکنندهای از توانایی این فناوری در شناسایی اهداف نظامی منتشر کرده است. در یکی از آزمایشها، مدل Claude Opus 5.5 متعلق به شرکت آنتروپیک، در ۲۲ مورد از ۳۲ بار بررسی تصاویر ماهوارهای، مدرسهای در شهر میناب ایران را بهعنوان هدف نظامی معرفی کرد.
این تحقیق که توسط مؤسسه مستقل Vals انجام شده، رفتار مدلهای هوش مصنوعی شرکتهایی مانند OpenAI، آنتروپیک، گوگل و دیپسیک را در سناریوهای شبیهسازیشده نظامی ارزیابی کرده است.
نتایج نشان میدهد بعضی مدلها در تشخیص اهداف غیرنظامی دچار خطا میشوند و تغییر نحوه ارائه درخواست میتواند احتمال همکاری آنها با سناریوهای خطرناک را افزایش دهد.
هوش مصنوعی کلاد چگونه مدرسه میناب را هدف نظامی تشخیص داد؟
پژوهشگران Vals از تصاویر ماهوارهای واقعی منطقهای در شهر میناب استفاده کردند که در آن یک مدرسه در مجاورت مجموعهای نظامی قرار داشت.
این تصاویر مربوط به سالهای ۲۰۲۴ و ۲۰۲۵ بودند؛ یعنی پیش از حمله ۲۸ فوریه ۲۰۲۶ به مدرسه شجره طیبه میناب که بیش از ۱۵۰ غیرنظامی، عمدتاً کودک، در آن کشته شدند.
پژوهشگران تصاویر را به مدلهای مختلف هوش مصنوعی ارائه کردند و از آنها خواستند مکانهایی را که هدف نظامی تشخیص میدهند، مشخص کنند.
نتیجه برای Claude Opus 5.5 قابلتوجه بود. این مدل در شرایط معمول ۲۲ بار از ۳۲ آزمایش ساختمان مدرسه را در فهرست اهداف نظامی قرار داد؛ رقمی معادل حدود ۶۹ درصد.
وقتی پژوهشگران همین تصاویر را بهعنوان بخشی از یک بازی معرفی کردند، تعداد انتخابهای اشتباه کلاد به ۲۳ مورد از ۳۲ آزمایش افزایش یافت.
نکته مهم این است که این آزمایش ماهها پس از حمله واقعی انجام شده و نشاندهنده نقش مستقیم Claude Opus 5.5 در آن حمله نیست.
عملکرد ChatGPT، جمنای و دیپسیک چگونه بود؟
نتایج پژوهش نشان میدهد مدلهای شرکتهای مختلف در شناسایی مدرسه میناب رفتار متفاوتی داشتهاند.
سه مدل GPT-6 Astra، GPT-6.1 Sol و GPT-6 Luna در سناریوی معمول، هیچکدام مدرسه را بهعنوان هدف نظامی انتخاب نکردند.
اما هنگامی که محققان سناریو را یک بازی معرفی کردند، رفتار این مدلها تغییر کرد.
در همین شرایط، مدل GPT-6 Astra در ۹ آزمایش، GPT-6.1 Sol در ۱۳ آزمایش و GPT-6 Luna در ۱۱ آزمایش از مجموع ۳۲ آزمایش، مدرسه را در فهرست اهداف قرار دادند.
مدلهای جمنای گوگل و دیپسیک نیز در بخشی از آزمایشها ساختمان مدرسه را اشتباه شناسایی کردند.
این نتایج نشان میدهد حتی مدلهایی که در شرایط عادی رفتار محتاطانهتری دارند، ممکن است در شرایط متفاوت محدودیتهای ایمنی خود را بهصورت یکسان رعایت نکنند.
معرفی جنگ بهعنوان بازی، رفتار هوش مصنوعی را تغییر داد
یکی از مهمترین یافتههای پژوهش Vals، تأثیر نحوه توصیف سناریو بر تصمیم مدلهای هوش مصنوعی است.
پژوهشگران دریافتند زمانی که تصاویر مربوط به موقعیتهای جنگی واقعی معرفی میشدند، بعضی مدلها از همکاری با درخواستهای شناسایی اهداف خودداری میکردند.
اما وقتی همان درخواستها در قالب یک بازی یا شبیهسازی ارائه شدند، نرخ همکاری تعدادی از مدلها بهشدت افزایش یافت.
برای نمونه، در آزمایش شناسایی اهداف از تصاویر پهپادی، نرخ انتخاب دستکم یک هدف توسط GPT-6 Astra از ۶ درصد در حالت معمول به ۹۲ درصد در حالت بازی افزایش پیدا کرد.
البته این آمار مربوط به آزمایش تصاویر پهپادی است و نباید با نتایج بررسی تصاویر ماهوارهای مدرسه میناب اشتباه گرفته شود.
پژوهشگران معتقدند این یافتهها ضعف برخی سازوکارهای محافظتی مدلهای هوش مصنوعی را در برابر درخواستهای حساس نشان میدهند.
هوش مصنوعی حتی غیرنظامیان و آمبولانسها را هدف تشخیص داد
پژوهش Vals تنها به تصاویر ماهوارهای محدود نبود.
در بخش دیگری از تحقیق، تصاویر شبیهسازیشده میدان جنگ در اختیار مدلهای مختلف قرار گرفت. این تصاویر شامل خودروهای نظامی، سربازان، افراد غیرنظامی، نیروهای امدادی و آمبولانسها بود.
برخی مدلها در این آزمایشها، غیرنظامیان، خودروهای امدادی و حتی سربازانی را که تسلیم شده بودند، در میان اهداف نظامی قرار دادند.
در آزمایشهای چندمرحلهای نیز مدلها پس از مشاهده پیامدهای شبیهسازیشده حملات، گاهی همچنان به ارائه اطلاعات ادامه میدادند.
نتایج این بخش از پژوهش نشان میدهد تشخیص حضور انسان در تصویر با تشخیص مجاز بودن هدف قرار دادن او تفاوت اساسی دارد.
آیا هوش مصنوعی در حمله واقعی به مدرسه میناب نقش داشت؟
در این بخش باید میان یافتههای پژوهش جدید و گزارشهای منتشرشده درباره حمله واقعی به مدرسه میناب تفاوت قائل شد.
پژوهش Vals هیچ مدرکی ارائه نمیکند که نشان دهد مدل Claude Opus 5.5 یا سایر مدلهای آزمایششده، مستقیماً در تصمیم حمله به مدرسه استفاده شدهاند.
بااینحال، گزارشهای تحقیقی درباره حمله فوریه ۲۰۲۶، به مشکلات اطلاعاتی، تصاویر قدیمی و اتکای بیشازحد برخی نیروهای نظامی به ابزارهای هوش مصنوعی اشاره کردهاند.
بنابراین، نتایج پژوهش جدید را باید هشداری درباره خطرات احتمالی استفاده از هوش مصنوعی در فرایندهای نظامی دانست، نه اثبات علت حمله واقعی.
واکنش شرکتهای OpenAI، آنتروپیک و گوگل
پس از انتشار نتایج، شرکتهای توسعهدهنده مدلهای هوش مصنوعی درباره کاربردهای نظامی محصولات خود توضیح دادند.
آنتروپیک اعلام کرد سناریوهای مورد بررسی با سیاستهای استفاده مجاز از مدلهای این شرکت سازگار نیستند و مدلهای کنونی هنوز دقت لازم برای کنترل مستقل تسلیحات را ندارند.
OpenAI نیز تأکید کرد استفاده غیرمجاز از مدلهای عمومی این شرکت برای تسهیل خشونت ممنوع است و ابزارهایی برای شناسایی سوءاستفاده در اختیار دارد.
گوگل هم اعلام کرد مدلهایش برای کنترل تسلیحات خودکار بدون نظارت انسانی مناسب طراحی نشدهاند.
چرا نتایج پژوهش Vals اهمیت دارد؟
استفاده از هوش مصنوعی در تحلیل تصاویر ماهوارهای، پردازش دادههای اطلاعاتی و پشتیبانی از تصمیمهای نظامی در حال گسترش است.
این فناوری میتواند حجم بزرگی از اطلاعات را با سرعت تحلیل کند، اما سرعت بالا لزوماً به معنای تشخیص صحیح یا رعایت اصول ایمنی نیست.
پژوهش Vals نشان میدهد مدلهای عمومی هوش مصنوعی ممکن است تحت شرایط خاص اطلاعاتی ارائه کنند که در صورت استفاده نادرست، پیامدهای خطرناکی برای غیرنظامیان داشته باشد.
این نتایج بار دیگر اهمیت نظارت انسانی، آزمونهای ایمنی مستقل و مسئولیتپذیری در توسعه سامانههای هوش مصنوعی نظامی را برجسته میکند.

دیدگاهها