گوگل دو سیستم جدید از خانواده TPU نسل هشتم خود را با نامهای TPU 8tx و TPU 8i Max معرفی کرده است؛ محصولاتی که بهترتیب برای اجرای امن و محرمانه مدلهای هوش مصنوعی و پردازش بارهای کاری با پنجرههای متنی بسیار بزرگ طراحی شدهاند.
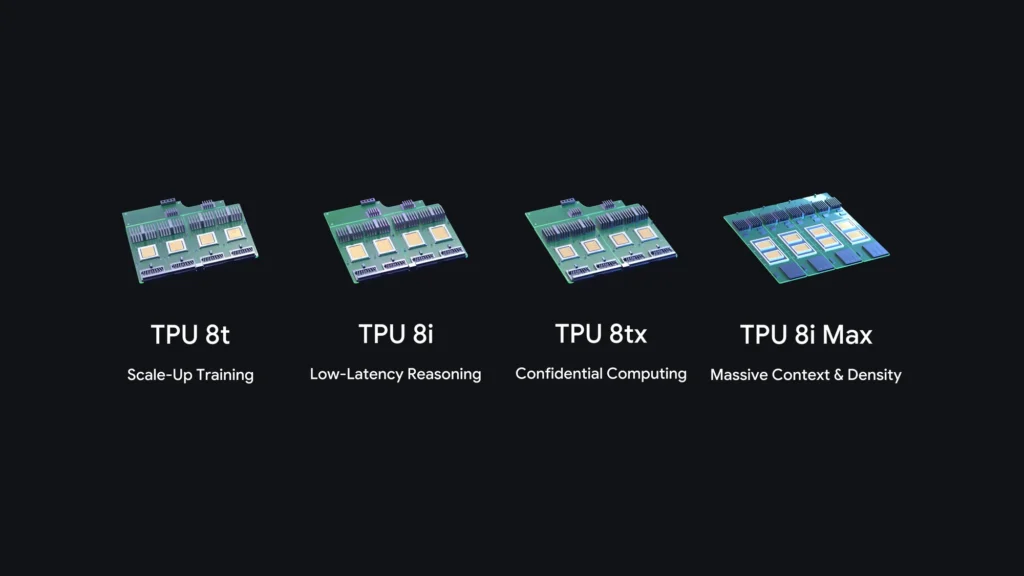
با معرفی این دو سیستم، خانواده TPU نسل هشتم گوگل اکنون شامل چهار مدل TPU 8t، TPU 8i، TPU 8tx و TPU 8i Max است. گوگل میگوید این نخستین بار است که چهار سیستم TPU را در یک سال معرفی میکند.
TPU 8tx برای اجرای امن مدلهای هوش مصنوعی ساخته شده است
TPU 8tx برای سازمانهایی طراحی شده که با دادههای بسیار حساس کار میکنند؛ از شرکتهای بزرگ گرفته تا نهادهای دولتی و صنایع تحت مقررات سختگیرانه.
این سیستم بر پایه همان سیلیکون TPU 8t ساخته شده، اما قابلیت Confidential Computing را مستقیماً در سطح سختافزار ارائه میدهد. در نتیجه، دادهها و وزنهای مدل حتی هنگام پردازش نیز میتوانند ایزوله و محافظت شوند.
گوگل میگوید TPU 8tx در کنار پردازندههای AMD EPYC نسل پنجم استفاده میشود و برای اجرای مدلهای اختصاصی، فاینتیونینگ خصوصی و ایجنتهای هوش مصنوعی حساس مناسب است.
تا دو برابر تأخیر کمتر نسبت به TPU 8t
TPU 8tx از شبکه کمتأخیر Boardfly استفاده میکند؛ همان معماری شبکهای که گوگل برای پردازش بلادرنگ و استدلال سریع توسعه داده است.
براساس اعلام گوگل، این سیستم میتواند تا دو برابر تأخیر کمتر نسبت به TPU 8t ارائه دهد، درحالیکه افت عملکرد ناشی از لایههای امنیتی تقریباً ناچیز است.
این ترکیب به سازمانها اجازه میدهد آموزش مدل، شخصیسازی و اجرای ایجنتها را روی یک زیرساخت مشترک انجام دهند.
TPU 8i Max برای مدلهای با کانتکست بسیار بزرگ ساخته شده است
دومین محصول جدید، TPU 8i Max، برای حل یکی از چالشهای اصلی مدلهای مدرن هوش مصنوعی یعنی محدودیت حافظه طراحی شده است.
گوگل برای ساخت این سیستم، دو تراشه TPU 8i را در یک پکیج واحد قرار داده است.
نتیجه این طراحی، دو برابر شدن قدرت پردازشی، SRAM و پهنای باند HBM نسبت به TPU 8i است.
تراکم پردازشی بیشتر در همان فضای رک
یکی از مزیتهای TPU 8i Max این است که گوگل توانسته دو برابر سیلیکون را در همان فضای فیزیکی رک قرار دهد.
این موضوع به مراکز داده اجازه میدهد قدرت پردازشی بیشتری را بدون افزایش متناسب فضای فیزیکی یا مصرف انرژی در اختیار داشته باشند.
گوگل TPU 8i Max را برای بارهای کاری با کانتکستهای چندمیلیون توکنی، پردازش کدهای بزرگ، ویدیوهای طولانی و سیستمهای چندایجنتی مناسب میداند.
خانواده TPU نسل هشتم حالا چهار عضو دارد
گوگل در اوایل سال ۲۰۲۶ TPU 8t و TPU 8i را معرفی کرده بود.
TPU 8t برای آموزش مدلهای بسیار بزرگ طراحی شده و TPU 8i روی استدلال بلادرنگ و کاهش تأخیر تمرکز دارد. گوگل گفته TPU 8t تا ۲.۷ برابر عملکرد آموزشی بهتر نسبت به نسل قبل ارائه میدهد و TPU 8i نیز تا ۸۰ درصد قیمتبهعملکرد بهتر در استنتاج دارد.
با اضافه شدن TPU 8tx و TPU 8i Max، گوگل اکنون برای هر مرحله از چرخه کاری هوش مصنوعی یک سیستم تخصصی ارائه میکند.
گوگل میخواهد TPUها را برای همه توسعهدهندگان قابلدسترستر کند
گوگل همزمان با معرفی سختافزارهای جدید، روی توسعه اکوسیستم نرمافزاری TPU نیز تمرکز کرده است.
این شرکت اخیراً TorchTPU را متنباز کرده تا توسعهدهندگان بتوانند کدهای PyTorch و مدلهای Hugging Face را بدون بازنویسی گسترده روی TPU اجرا کنند.
همچنین ابزارهایی مانند TPU Sync، Cloud Pathways و Agent Compute Engine برای مدیریت حافظه، توزیع بارهای کاری و کاهش مصرف منابع معرفی شدهاند.
TPU Sync انتقال داده را تا بیش از ۹۰ درصد سریعتر میکند
یکی از فناوریهای مهم جدید گوگل TPU Sync است که بهعنوان یک لایه مدیریت وضعیت مدل در کلاسترهای TPU عمل میکند.
این سیستم حافظه HBM، حافظه میزبان، فضای ذخیرهسازی و شبکه دیتاسنتر را بهصورت یک ساختار واحد مدیریت میکند.
گوگل میگوید TPU Sync میتواند تأخیر انتقال KV Cache و زمان رسیدن به اولین توکن را در برخی سناریوها بیش از ۹۰ درصد کاهش دهد.
رقابت زیرساخت هوش مصنوعی وارد مرحله تازهای شده است
گوگل بیش از یک دهه است که TPUها را برای اجرای مدلهای هوش مصنوعی توسعه میدهد و اکنون این محصولات نهتنها برای سرویسهای داخلی مانند Gemini، بلکه برای مشتریان Google Cloud نیز استفاده میشوند.
طبق اعلام گوگل، کسبوکار TPU این شرکت اکنون نزدیک به ۱۰۰ مشتری دارد؛ از آزمایشگاههای هوش مصنوعی پیشرفته گرفته تا شرکتهای مالی، دانشگاهها و خردهفروشان.
معرفی TPU 8tx و TPU 8i Max نشان میدهد گوگل درحال حرکت از طراحی یک شتابدهنده عمومی به سمت ساخت سیستمهای تخصصی برای نیازهای متفاوت عصر ایجنتهای هوش مصنوعی است.

دیدگاهها